ASUS ProArt P16 (H7607) met RTX Spark review: een 120B-model op schoot, maar video vraagt geduld
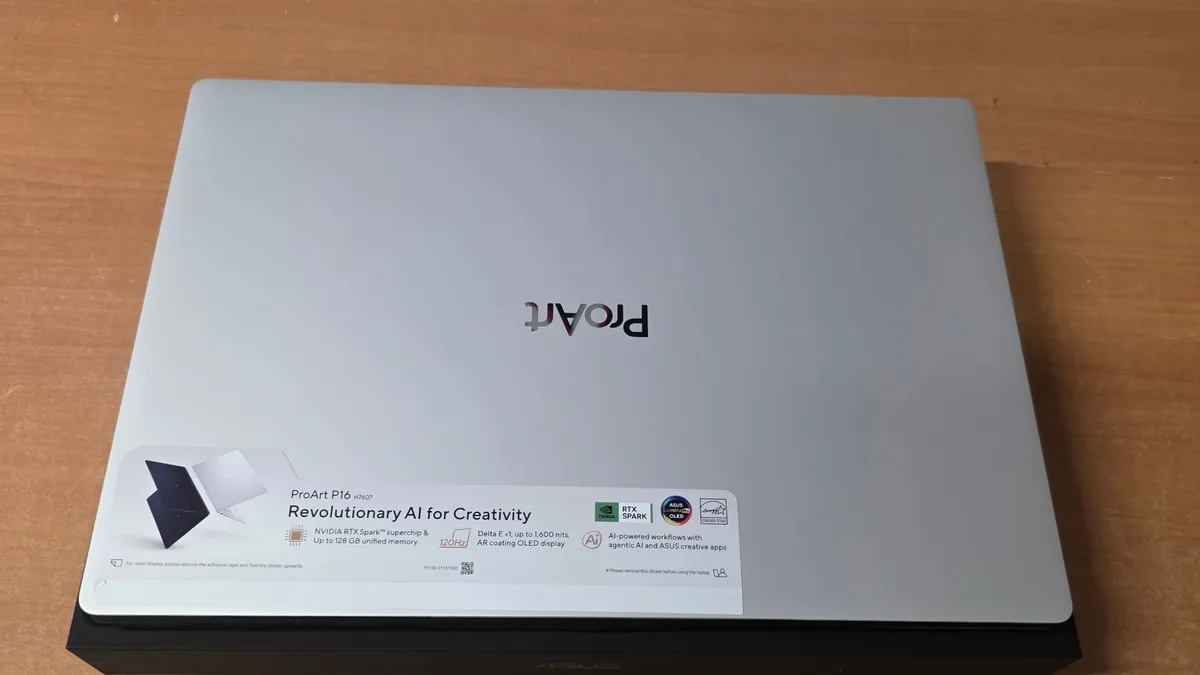
Een paar dagen geleden kwam hij binnen: de ASUS ProArt P16 (H7607) met NVIDIA's RTX Spark-chip en 128GB unified memory. Over accuduur en scherm is elders al genoeg gemeten, dus wij richten ons op waar deze laptop voor gebouwd is: lokale AI. We draaiden twee dagen lang grote taalmodellen in LM Studio en lieten ComfyUI video maken met Wan 2.2. De korte versie: een taalmodel van 120B parameters draait vlotter dan we hadden verwacht, maar voor AI-video heb je geduld of slimme instellingen nodig. Alle uitvoeringen, specificaties en prijzen vind je in ons eerdere artikel over de ProArt P16.
Inhoudsopgave
Spring direct naar een onderdeel:
- Kort samengevat
- Uitpakken: ASUS maakt er een moment van
- Ontwerp en binnenkant
- Ons testexemplaar
- Lokale taalmodellen: hier blinkt hij uit
- AI-video met Wan 2.2: het kan, maar met geduld
- Windows on ARM: het werkt, maar je loopt voorop
- Geluid
- Accu en scherm
- Prijs: €6.499, met een monitor erbij
- Voor wie is de ProArt P16 met RTX Spark?
- Ons oordeel
Kort samengevat
Wat we na twee dagen testen weten:
- NVIDIA's Nemotron 120B draait lokaal met zo'n 35 tokens per seconde. Dat is ruim sneller dan je kunt lezen.
- Grote modellen laden duurt 4 tot 7 minuten, en twee grote modellen tegelijk past ook in 128GB niet.
- AI-video met Wan 2.2 in 720p kost met de standaardinstellingen 64 tot 76 minuten per clip van 5 seconden. Met een Lightning-LoRA is dat 9,6 minuten.
- ComfyUI en LM Studio draaien gewoon op Windows on ARM, maar versnellers als SageAttention en torch.compile werken (nog) niet.
- Onder AI-belasting hoor je de ventilatoren duidelijk, maar hinderlijk hard wordt het niet.
Uitpakken: ASUS maakt er een moment van
De ProArt P16 komt in een zwarte verzenddoos met ProArt-lijnwerk, met daarin een tweede doos die in folie geseald is. Klap je die open, dan lees je eerst 'Where Your Story Begins' en een QR-code. Pas daaronder ligt de laptop, op een zwarte sokkel met ASUS-logo. Een oplader zit er niet bij: de laptop laadt via USB-C met maximaal 140W, dus die moet je apart regelen als je er nog geen hebt.
Ontwerp en binnenkant
Ons exemplaar is de 128GB-uitvoering (H7607BA-SE181X) in Neo White: een zilveren aluminium behuizing met een spierwit toetsenbord. Links en rechts van het toetsenbord zitten brede speakerroosters, een numeriek blok is er niet. Het haptische touchpad is groot en naast Alt Gr zit een Copilot-toets. Met 1,77kg is het voor een 16 inch-laptop met deze rekenkracht geen zwaargewicht.
Onder de bodemplaat is het opvallend opgeruimd. Er zit geen losse videokaart en geen geheugenlat: processor, GPU en geheugen zitten samen in de RTX Spark-chip in het midden, gekoeld door twee ventilatoren met heatpipes. De SSD zit in een M.2-slot onder een afscherming en de accu neemt de hele onderste helft in. Het geheugen uitbreiden kan dus niet. Kies bij aankoop meteen de uitvoering die je nodig hebt.
Ons testexemplaar
Dit is de configuratie waarop alle testresultaten hieronder zijn gemeten:
| Onderdeel | ASUS ProArt P16 H7607BA-SE181X |
|---|---|
| Chip | NVIDIA RTX Spark N1X: 20-core processor en Blackwell-GPU met 6.144 cores |
| Geheugen | 128GB unified memory, waarvan de GPU ongeveer 110GB kan gebruiken |
| Opslag | 1TB SSD |
| Scherm | 16 inch 4K OLED (3840x2400), 120Hz |
| Besturingssysteem | Windows 11 Pro op ARM |
| Prijs | €6.499 bij bol.com |
Dat de GPU niet alle 128GB krijgt, is normaal: Windows en je programma's hebben ook geheugen nodig. ComfyUI meldde bij ons 112GB als beschikbaar videogeheugen. Dat is nog altijd bijna vijf keer zoveel als de 24GB van een laptop-RTX 5090.
Lokale taalmodellen: hier blinkt hij uit
We gebruikten LM Studio zoals je dat dagelijks zou doen: vragen stellen, code laten schrijven en documenten laten samenvatten. Over twee dagen kwamen we zo op ruim 300 verzoeken. Geen synthetische benchmark dus, maar de mediaan van echt gebruik. 'Prompt verwerken' is hoe snel het model jouw tekst inleest (gemeten bij prompts vanaf 2.000 tokens), 'tekst genereren' hoe snel het antwoord verschijnt.
| Model | Prompt verwerken | Tekst genereren | Laadtijd |
|---|---|---|---|
| NVIDIA Nemotron 3.5 Super VL 120B-A12B (Q4_K_M) | 425 tot 466 tokens/s | 35 tokens/s | 5,5 tot 7 min |
| Qwen3-Coder-Next (Q6_K) | 820 tot 890 tokens/s | 39 tot 43 tokens/s | 3,8 tot 5,5 min |
| Qwen3.8 27B (Q4_K_M) | 432 tot 672 tokens/s | 19 tot 28 tokens/s | 16 tot 20 sec |
35 tokens per seconde voor een model van 120B parameters is een prettig tempo: het antwoord loopt sneller over je scherm dan je het kunt lezen. Een document van ruim 8.000 tokens (een stuk of vijftien pagina's tekst) had Nemotron binnen 20 seconden ingelezen. Een eerlijke kanttekening: Nemotron is een zogeheten mixture-of-experts-model. Van de 120B parameters zijn er per token maar 12B actief (daar staat de A12B in de naam voor). Dat is precies waarom het zo vlot gaat. Een 'dicht' model van dezelfde grootte zou een stuk trager zijn, al past het wel in het geheugen.
Nemotron gebruikte bovendien speculative decoding: een klein hulpmodel voorspelt alvast een paar tokens, die het grote model alleen nog hoeft te controleren. Bij ons werd 60 tot 100 procent van die voorspellingen goedgekeurd, en dat scheelt merkbaar in snelheid.
Hoe groot dat verschil met een dicht model is, zie je aan Qwen3.8 27B. Dat model gebruikt voor elk token al zijn 27B parameters, en haalt daarmee zo'n 24 tokens per seconde (de mediaan): nog steeds vlotter dan je leest, maar duidelijk trager dan Nemotron, dat ruim vier keer zo groot is. Ook Qwen3.8 voorspelt tokens vooruit, en hoeveel daarvan goedgekeurd wordt hangt sterk af van de taak. Bij de ene vraag was dat 91 procent en haalde het model 28 tokens per seconde, bij een andere maar 51 procent en 19 tokens per seconde. Wel stond het binnen 20 seconden klaar, waar je bij de grote modellen minuten wacht.
Wat ook opvalt: hoe langer het gesprek, hoe trager het inlezen. Aan het begin van een gesprek las Qwen3.8 zo'n 670 tokens per seconde in, met 80.000 tokens aan gespreksgeschiedenis nog zo'n 430. Een lang gesprek of een groot document voelt dus steeds wat stroperiger aan. Deze cijfers komen uit ruim twintig verzoeken op één dag, minder dan de twee dagen gebruik bij de andere twee modellen. Verzoeken met een afbeelding erin hebben we niet meegeteld bij het inlezen.
Wat minder goed gaat
Laden kost tijd. Vier tot zeven minuten voordat een groot model klaarstaat is lang als je even snel iets wilt vragen. En 128GB is ruim, maar niet eindeloos. Toen Nemotron nog in het geheugen stond en we Qwen3-Coder-Next erbij wilden laden, weigerde LM Studio: er moest nog 62GB bij, en dat was er niet. Twee grote modellen naast elkaar draaien zit er dus niet in. Wil je wisselen, dan laad je het ene model uit en wacht je opnieuw een paar minuten op het andere.
AI-video met Wan 2.2: het kan, maar met geduld
Voor video gebruikten we Wan 2.2 14B (image-to-video, fp8) in ComfyUI. Elke clip is 1280x720 pixels en 81 frames op 16 fps, goed voor ruim 5 seconden. Het laden ging moeiteloos: de twee Wan-modellen van 14B passen ruim in het geheugen. De rekentijd is een ander verhaal.
| Instelling | Stappen | Tijd per stap | Tijd per clip |
|---|---|---|---|
| Standaard (cfg 4) | 10 + 10 | 170 tot 237 seconden | 64 tot 76 minuten |
| Lightning-LoRA (lightx2v, 4 stappen) | 2 + 2 | 56 seconden | 9,6 minuten |
Onze vier runs met de standaardinstellingen duurden 1 uur en 4 minuten, 1 uur en 7 minuten (twee keer) en 1 uur en 16 minuten. Een filmpje van 20 seconden uit vier clips is dan een nachtklus. Ter indicatie: op onze desktop met een RTX 5070 Ti duurde een Wan-clip eerder zo'n 40 minuten. Voor video is een losse desktopkaart dus duidelijk sneller, ondanks het veel kleinere videogeheugen.
Met de Lightning-LoRA verandert het beeld. Die laat Wan met 4 stappen in plaats van 20 werken, en dan staat een 720p-clip er in minder dan tien minuten. Dat is ruim zes keer zo snel en maakt proberen en bijsturen ineens wel praktisch. De prijs: de beweging valt met Lightning soms wat rustiger uit dan met de volledige 20 stappen.
Over de beeldkwaliteit zijn we te spreken. In onze testvideo van een vrouw met een olielamp in een donker bos bleef het personage over alle shots herkenbaar: dezelfde vlecht, dezelfde trui, hetzelfde gezicht. Het warme licht van de lamp valt overtuigend op gezicht en handen. Het zwakke punt zit in de donkerste shots, waar details in het zwart verdwijnen.
Windows on ARM: het werkt, maar je loopt voorop
Het goede nieuws: zowel LM Studio als ComfyUI Desktop draaide bij ons zonder gedoe, native op ARM. ComfyUI gebruikt daarvoor een ARM-versie van Python en een PyTorch-ontwikkelversie met CUDA-ondersteuning. Het zware rekenwerk gebeurt op de GPU, dus de ARM-processor zelf remt niet. Wel ontbreekt Triton, en daarmee twee versnellers die op een gewone RTX-pc juist populair zijn voor Wan-video: SageAttention en torch.compile. Die tijdwinst mis je hier voorlopig. Daar staat tegenover dat ComfyUI de nieuwe rekenformaten van Blackwell, zoals NVFP4, wel al ondersteunt. Modellen in dat formaat zijn kleiner en kunnen het rekenwerk versnellen.
Gebruik je naast AI ook andere software, check dan vooraf of die op Windows on ARM werkt. Oudere x86-programma's draaien via emulatie, en een deel draait helemaal niet.
Geluid
Bij lange AI-taken gaan de twee ventilatoren hoorbaar blazen, en ze blijven draaien tot de taak klaar is. Een opstijgend vliegtuig is het niet: je hoort dat hij aan het werk is, maar in een kantoor of woonkamer stoort het niet. Een decibelmeting hebben we niet gedaan. Expert Reviews merkte hetzelfde op: de ventilatoren slaan hoorbaar aan bij een zware GPU-taak en blijven draaien tot die klaar is.
Accu en scherm
Daar zijn al goede metingen van, dus die doen we niet nog eens over. Expert Reviews mat het volgende:
- Accuduur: 10 uur en 47 minuten in een eenvoudige accutest
- Piekhelderheid: 1.596 nits met HDR-materiaal
- Kleurbereik: 98 procent van DCI-P3
- Kleurafwijking: Delta E van 1,01 (sRGB) en 0,97 (DCI-P3)
De belofte van een Delta E onder de 1 maakt het scherm daarmee vrijwel waar. De accuduur is degelijk, maar Expert Reviews zag een 16 inch-MacBook Pro bijna twee keer zo lang meegaan. En de AI-taken uit deze review doe je sowieso aan de lader.
Prijs: €6.499, met een monitor erbij
Onze 128GB-uitvoering kost €6.499 bij bol.com. Op het moment van schrijven krijg je daar gratis een ASUS ProArt-monitor bij. Hoe lang die actie loopt, staat er niet bij. Wil je minder uitgeven: de 64GB-versie kost €4.999, en de kleinere ProArt P14 met 64GB staat bij bol.com voor €4.699. Een overzicht van alle uitvoeringen staat in ons eerdere artikel.
ASUS ProArt P16 H7607BA-SE181X (RTX Spark, 128GB)
- processorNVIDIA RTX Spark N1X (20-core)
- ram128GB unified memory
- opslag1TB SSD
- gpuBlackwell GPU (6.144 cores)
- scherm16" 4K OLED touchscreen (3840x2400) 120Hz
- gewicht1,77kg
- kleurNeo White
In onze test draaide NVIDIA's Nemotron 120B hierop met zo'n 35 tokens per seconde. 128GB unified memory, waarvan de GPU ongeveer 110GB kan gebruiken
Let op
AI-video met Wan 2.2 in 720p kost met de standaardinstellingen ruim een uur per clip. Windows on ARM, zonder SageAttention of torch.compile. Geen oplader in de doos en het geheugen zit vast
Koop dit niet als: je geen modellen boven ongeveer 90B draait: dan is de 64GB-uitvoering de verstandigere keuze
Voor wie is de ProArt P16 met RTX Spark?
Werk je met grote taalmodellen en wil je die lokaal houden, bijvoorbeeld omdat je met gevoelige documenten werkt of offline moet kunnen werken? Dan is dit, naast een MacBook Pro met veel geheugen, een van de weinige laptops waarop een model van 120B parameters gewoon bruikbaar draait, en op Windows de eerste met CUDA. Ook voor ontwikkelaars die met een lokale coding-assistent willen werken is het een sterke machine. Maak je vooral AI-video, dan is hij met de standaardinstellingen te traag om productief te zijn. Met de Lightning-LoRA wordt het werkbaar, maar een desktop met een losse RTX-kaart blijft sneller. En draai je modellen tot ongeveer 30B, dan heb je deze laptop niet nodig: een RTX 5090-laptop of een MacBook Pro kan dat ook, voor minder geld.
Ons oordeel
De ASUS ProArt P16 met RTX Spark doet waar hij voor gebouwd is: grote taalmodellen lokaal draaien, op een tempo waar je echt mee kunt werken. Op Windows kon dat tot nu toe geen enkele laptop. Voor AI-video is de rekenkracht de grens, niet het geheugen, en Windows on ARM mist nog een paar versnellers die je op een gewone RTX-pc wel hebt. Voor €6.499 koop je dus vooral een draagbare werkplek voor taalmodellen. Wie dat zoekt, krijgt er iets unieks voor terug. Wie vooral video wil maken, kan beter wachten tot de software op ARM volwassener is.
Veelgestelde vragen
Hoe snel draait een 120B-model op de ASUS ProArt P16?
In onze test genereerde NVIDIA Nemotron 3.5 Super 120B (Q4_K_M) in LM Studio zo'n 35 tokens per seconde, en las het prompts in met 425 tot 466 tokens per seconde. Dat is vlot genoeg om prettig mee te werken. Het gaat wel om een mixture-of-experts-model met 12B actieve parameters per token.
Kun je AI-video maken op de ProArt P16 met RTX Spark?
Ja. Wan 2.2 14B draait in ComfyUI in 720p. Met de standaardinstellingen kost een clip van 5 seconden 64 tot 76 minuten, met een 4-stappen Lightning-LoRA 9,6 minuten.
Draait ComfyUI op Windows on ARM?
Ja, ComfyUI Desktop draaide bij ons native op ARM, met een PyTorch-versie met CUDA-ondersteuning. Triton ontbreekt nog, dus SageAttention en torch.compile kun je niet gebruiken.
Is de ASUS ProArt P16 met RTX Spark luid?
Bij lange AI-taken hoor je de ventilatoren duidelijk, maar hinderlijk hard wordt het niet. Een decibelmeting hebben we niet gedaan.
Heb ik 128GB nodig of is 64GB genoeg?
Voor modellen boven ongeveer 90B parameters, zoals Nemotron 120B, heb je de 128GB-uitvoering nodig. Draai je kleinere modellen, dan is de 64GB-versie voor €4.999 de verstandigere keuze.